全部小册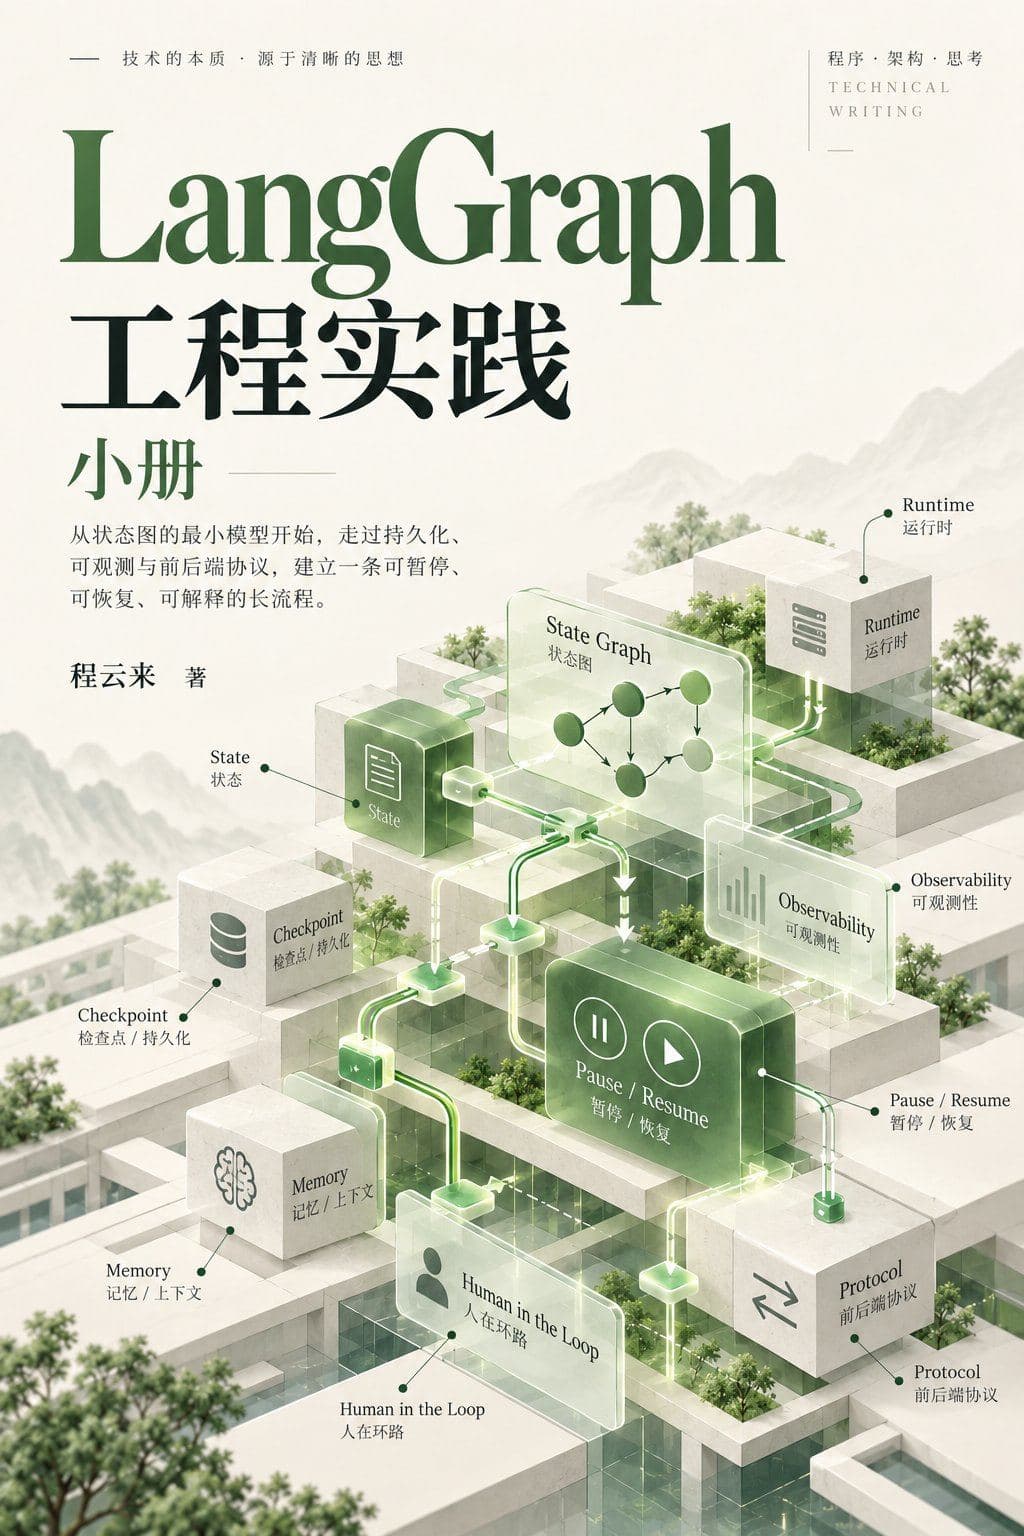
LangGraph 工程实践
8 章 · 3 篇最近更新 2026年8月24日
从状态图的最小模型开始,走过持久化、可观测与前后端协议,建立一条可暂停、可恢复、可解释的长流程。
这本书讨论的不是「如何把模型接进一个 Agent」,而是当一条流程会跨请求等待、遇到外部失败、需要人工决定时,如何让它仍然有状态、可恢复、可解释。
八章分三篇。核心流程先让执行有一条可解释的轨迹,再处理「审核要等到明天」的持久化和人工暂停,接着是重试、预算和幂等。可观测性回答运行之后团队要面对的三个问题:用户现在应该看到什么、为什么一次运行变慢或失败、反馈如何沉淀成下一次可验证的改动。前后端协议收尾在一个常被低估的边界上——LangGraph 知道节点和 State,LLM 知道 token 和 tool call,但浏览器需要的是能直接渲染的 UI 语义。
每一章都从上一章留下的限制开始,而不是按 API 名称罗列能力。
目录
第 1 篇核心流程
- 01LangGraph(一):先让流程有一条可解释的执行轨迹从一条会中途失败的资料调研流程开始,建立 State、Node、Edge 和 compile 的最小模型,并跑通一个可验证的状态图。约 11 分钟
- 02LangGraph(二):审核要等到明天,状态如何回来从进程重启和人工审核的真实限制出发,理解 Checkpointer、thread_id、Store 与 interrupt / resume 的边界。约 9 分钟
- 03LangGraph(三):重试不等于可靠,让失败停在边界内把网络失败、模型判断和外部副作用分开,沿着恢复路径设计重试、预算与幂等,而不是给整条图套一个重试装饰器。约 8 分钟
- 04LangGraph(四):上线前,先证明这条图值得维护从一次慢、错或重复发布的运行出发,建立 LangGraph 的追踪、测试、成本和并发边界,再判断什么时候普通函数或任务队列更合适。约 8 分钟
第 2 篇可观测性
- 05LangGraph(五):过程监控不是把 State 推到页面从一个只有旋转图标的运行页面出发,区分用户进度、执行诊断和内容流,设计可排序、可重连、可脱敏的事件协议。约 14 分钟
- 06LangGraph(六):先让 Phoenix 留下可解释的证据从本地部署 Phoenix 开始,理解 OpenTelemetry、OpenInference 和 LangGraph 的接入边界,并建立一套可查询、可脱敏的 Trace 与指标。约 12 分钟
- 07LangGraph(七):反馈按钮怎样变成调优闭环把前端反馈、后端事实、Phoenix Trace、离线评估和灰度发布串起来,让一次‘不好用’能推动下一版系统被验证地改进。约 10 分钟