菜鸟教程里的“运行”按钮,究竟运行在哪里
先看一个读者很熟悉的场景:在菜鸟教程的代码示例旁边,页面同时展示源代码、运行按钮和输出区域。点击按钮后,页面立刻出现了计算结果。
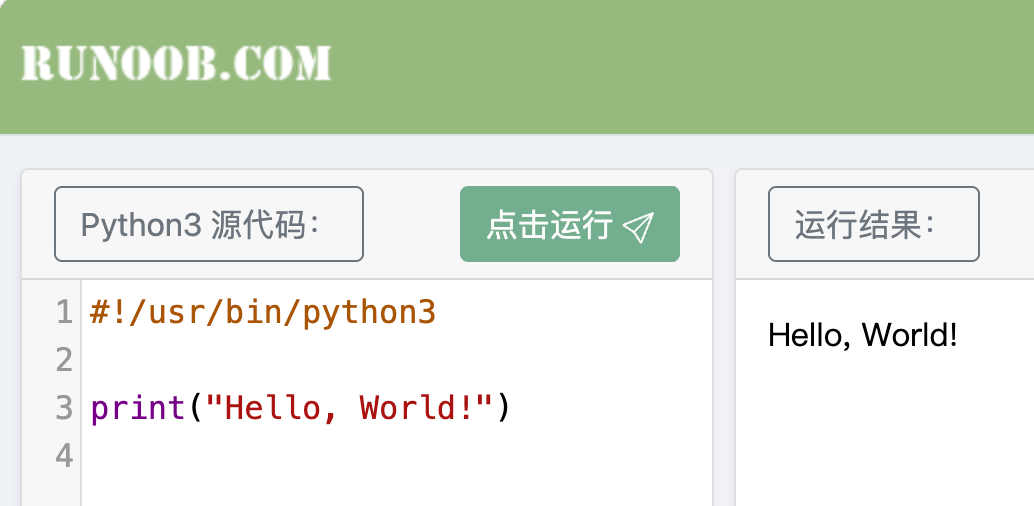
于是问题变成了:浏览器为什么可以运行一段并非 JavaScript 的代码?一次点击背后到底经过了哪些运行时?
执行可以分为4个阶段
从静态代码块 print("Hello, World") 到输出“Hello, World”,可以沿着四个阶段跑通一条最小路径:
- 只读代码块保存作者写入的源代码;
- 语言运行器准备解释器、编译产物或语言依赖;
- Worker 或其它隔离机制承载实际计算,避免阻塞页面;
- 输出面板显示标准输出、错误和耗时。
查看 Mermaid 源码
flowchart LR
    source[1. 只读代码块] -->|固定源代码| runner[2. 语言运行器]
    runner -->|准备解释器 / 编译产物| worker[3. Worker 或其它隔离机制]
worker -->|stdout / stderr / duration| output[4. 输出面板]四个阶段的职责保持不变。按语言替换的是第二阶段的语言运行器:Python 使用 Pyodide1,JavaScript 可以使用原生 JavaScript 运行器,SQL 可以使用 SQLite-Wasm2 或 DuckDB-Wasm3。第三阶段是承载机制,页面最终只接收同一组执行结果。
四个阶段分别要解决什么问题
只读代码块:先确定输入
先放一个平平无奇的代码块。它只负责展示代码,不显示运行按钮:
print("Hello, World")在页面上,它只是一个代码围栏。它可以用下面的 HTML 代码块表示:用 data-language 保存语言标识,用 data-code 节点保存源代码:
<section class="demo" data-example="success" data-language="python">
  <pre><code data-code>print("Hello, World")</code></pre>
</section>
渲染层读取这两个位置后,把代码块表示成一个最小输入对象。这个输入契约可以写成:
type CodeInput = {
  language: string;
  code: string;
};
页面初始化时,先找到所有示例卡片,再逐个交给 connectDemo:
const cards = document.querySelectorAll<HTMLElement>("[data-example]");
cards.forEach((card) => connectDemo(card));
这里的 card 就是当前示例的 <section class="demo" data-example="success" data-language="python"> 元素。connectDemo 接收这张卡片,负责把卡片里的代码、按钮和输出区域连接起来:
function connectDemo(card: HTMLElement): void {
  const elements = getElements(card);
  let runner: CodeRunner | null = null;

  elements.runButton.addEventListener("click", async () => {
    const input: CodeInput = {
      language: elements.language,
      code: elements.code,
    };

    runner = createRunner(input.language);
    const result = await runner.run(input.code, (status) => {
      elements.status.textContent =
        status === "running" ? "执行中" : `加载 ${input.language}`;
    });
    elements.output.textContent = result.ok ? result.stdout : result.stderr;
  });
}
connectDemo 先调用 getElements(card),把 DOM 元素转换成便于使用的对象。用原生 JavaScript 解析非常直接:dataset 读取元素上的 data-* 自定义属性,textContent 读取节点中的代码文本:
type DemoElements = {
  language: string;
  code: string;
  status: HTMLElement;
  output: HTMLOutputElement;
  runButton: HTMLButtonElement;
  resetButton: HTMLButtonElement;
};

function getElements(card: HTMLElement): DemoElements {
  return {
    language: card.dataset.language || "python",
    code: card.querySelector<HTMLElement>("[data-code]")!.textContent,
    status: card.querySelector<HTMLElement>("[data-status]")!,
    output: card.querySelector<HTMLOutputElement>("[data-output]")!,
    runButton: card.querySelector<HTMLButtonElement>("[data-run]")!,
    resetButton: card.querySelector<HTMLButtonElement>("[data-reset]")!,
  };
}
card.dataset.language 读取 data-language="python",得到字符串 python;card.querySelector("[data-code]").textContent 先找到代码节点,再得到 print("Hello, World")。这两个值组成 CodeInput,其余字段用于按钮、状态和输出。至此,只读代码块定义完毕:它提供语言标识和源代码,不负责选择解释器,也不负责执行。
语言运行器:由运行时和适配器组成
代码块已经整理出一份输入:language 说明代码使用哪种语言,code 保存 print("Hello, World")。输入本身还不能执行,需要把语言标识连接到一个具体的运行器。
一个语言运行器由两部分组成:语言运行时负责真正解释、编译或执行代码;适配器是项目自己编写的代码,负责加载运行时、调用它的 API、捕获输出和异常,并把这些细节接成页面统一的接口。Python 的运行时可以是 Pyodide,适配器则是我们需要实现的代码。
先约定所有具体 Runner 的行为。无论内部使用哪种语言运行时,页面都只调用 run 执行一次代码,调用 dispose 回收本次运行占用的资源:
type RunResult = {
  ok: boolean;
  stdout: string;
  stderr: string;
  duration: number;
};

type CodeRunner = {
  run(code: string, onStatus: (status: string) => void): Promise<RunResult>;
  dispose(): void;
};
RunResult 约定一次执行返回哪些数据,CodeRunner 约定具体 Runner 必须提供哪些行为。Python Runner、JavaScript Runner 或 SQL Runner 的内部实现可以不同,但都必须满足这两个契约。
有了这个接口,页面无需知道 Runner 内部是 Pyodide、JavaScript 引擎还是 SQL 引擎。接下来还需要一个组装位置,根据 language 创建具体 Runner。当前示例只注册 Python,并由 createWorkerRunner(workerUrl) 工厂创建一个符合 CodeRunner 接口的对象:
const PYTHON_WORKER_URL: string = "./workers/python.worker.js";

function createRunner(language: string): CodeRunner {
  if (language === "python") {
    return createWorkerRunner(PYTHON_WORKER_URL);
  }
  throw new Error(`暂未注册 ${language} Runner`);
}
createRunner 就是组装器。它读取 language,选择对应的 Runner 工厂;传入 python 时,调用 createWorkerRunner(PYTHON_WORKER_URL) 创建具体 Runner,传入尚未注册的语言时在这里报错。它不读取或执行 code,真正执行代码的动作统一放在返回对象的 run 方法中。
Python Runner 的适配器在当前实现中分成两段:createWorkerRunner 负责主线程一侧的 run、dispose 和 Worker 生命周期;workers/python.worker.js 负责 Worker 内部的 Pyodide 加载、Python 执行以及输出转换。这两段代码都由项目自己编写,并共同依赖 Pyodide 这个第三方运行时。
createRunner 的组装关系可以表示为:
查看 Mermaid 源码
flowchart LR
    language["input.language"] --> assembly["createRunner(language)"]
    assembly -->|python| python["Python Runner<br/>适配器 + Pyodide"]
    assembly -.->|javascript| javascript["JavaScript Runner<br/>适配器 + JavaScript 运行时"]
    assembly -.->|sql| sql["SQL Runner<br/>适配器 + SQL 运行时"]
    python --> contract["CodeRunner<br/>run / dispose"]
    javascript -.-> contract
sql -.-> contract页面只使用组装结果:
runner = createRunner(input.language)
result = await runner.run(input.code, onStatus)
runner.dispose()
createRunner 只负责 language → 具体 Runner 的组装,run 才接收源代码。onStatus 把加载和执行进度交给 UI,dispose 负责终止 Worker 并释放本次运行的资源。以后增加 JavaScript 或 SQL Runner,只需让新的具体 Runner 实现相同的 CodeRunner 接口,并在 createRunner 中注册它。
runner.run(input.code) 现在确定了调用边界,但解释器还没有执行位置。接下来要为这次调用安排一个不会阻塞页面的执行上下文。
Worker:把计算从页面线程移开
Python Runner 由 createWorkerRunner(PYTHON_WORKER_URL) 创建。Pyodide 初始化和 Python 计算都可能耗时,不能让它们占住页面主线程;这一阶段要解决的是执行位置。
这一阶段接收 runner.run(input.code),把同一份 code 送入独立上下文,再把 status 和 result 交回主线程;它不改变输入契约,也不负责决定使用哪种语言。
createWorkerRunner 接收一个脚本地址,返回同样的 run / dispose 接口。它把代码发给 Worker,等待 Worker 返回状态或结果:
function createWorkerRunner(workerUrl: string): CodeRunner {
  let worker: Worker | null = null;

  const run = (code: string, onStatus: (status: string) => void) =>
    new Promise<RunResult>((resolve) => {
      const currentWorker = new Worker(workerUrl, { type: "classic" });
      worker = currentWorker;
      currentWorker.onmessage = ({ data }: MessageEvent<StatusMessage | ResultMessage>) => {
        if (data.type === "status") {
          onStatus(data.status);
          return;
        }
        resolve(data);
        currentWorker.terminate();
        worker = null;
      };
      currentWorker.postMessage({ type: "run", code } satisfies RunMessage);
    });

  return { run, dispose: () => worker?.terminate() };
}
这里的 workerUrl 是 "./workers/python.worker.js",它只是 Worker 入口脚本的地址,不是 Pyodide 本身,也不是安装包自动生成的文件。这个入口脚本由项目自己编写,浏览器先加载它,再由它加载 Pyodide。new Worker(workerUrl) 创建独立执行上下文;postMessage 发送代码;onmessage 接收状态或最终结果;收到结果后终止 Worker,避免旧任务继续占用资源。
最小协议包含三类消息:
type RunMessage = { type: "run"; code: string };
type StatusMessage = { type: "status"; status: "loading" | "running" };
type ResultMessage = {
  type: "result";
  ok: boolean;
  stdout: string;
  stderr: string;
  duration: number;
};
run 从主线程流向 Worker;status 和 result 返回主线程。解释器对象、Python 对象或数据库连接不跨越边界,页面只接收字符串、布尔值和数字。Worker 内部调用 Pyodide、JavaScript 引擎还是 SQLite-Wasm,属于语言适配器的实现细节,不会改变这组消息。
对 Python 这条路径来说,Worker 文件内部还要完成一次运行时接入:先用 importScripts 加载 Pyodide 的脚本,再调用 loadPyodide 得到 Python 运行时,最后把 code 交给 runPythonAsync。因此,Worker 是承载位置,Pyodide 是运行时,python.worker.js 是把两者接到消息协议上的适配器。
查看 Mermaid 源码
flowchart LR
    page[app.js] -->|加载项目文件| worker[workers/python.worker.js]
    worker -->|importScripts| loader[Pyodide pyodide.js]
    loader -->|loadPyodide| runtime[CPython WebAssembly / 标准库]
worker -->|runPythonAsync| runtimeapp.js 的控制器负责页面与 Worker 的生命周期,python.worker.js 负责 Worker 内的消息、状态、错误和结果协议,Pyodide 负责真正解释和执行 Python。每次 run 先清理旧实例,再创建 Worker;收到结果、加载错误或超时,都调用同一个 dispose。runner.run(input.code) 至此有了实际承载位置,并会收到 status 和 result。
输出面板:把运行过程变成可观察结果
Worker 会把 status 和最终 result 发回主线程,按钮回调中的 onStatus 和 result 接收位置已经准备好。现在只需把这两类消息映射到状态文本和输出面板。
这一阶段接收 Worker 消息,输出用户可见的状态、标准输出、错误和耗时;页面只按结果契约渲染,不需要理解 Pyodide 的对象。
CodeRunner 已经约定 run 返回 RunResult。其中 ok 表示本次执行是否成功,stdout 保存标准输出,stderr 保存错误信息,duration 保存耗时;页面不需要再从一个字符串中猜测本次运行属于成功、异常、加载失败还是超时。
status 消息表示“加载中”或“执行中”;RunResult 表示一次运行已经结束。无论底层是 Python 异常、SQL 语法错误还是编译失败,都转换到 stderr,页面不需要识别具体异常类型。
按钮回调先处理过程状态,再处理最终结果:
const result = await runner.run(input.code, (status) => {
  elements.status.textContent =
    status === "running" ? "执行中" : `加载 ${input.language}`;
});

elements.status.textContent = result.ok ? "已完成" : "运行失败";
const output = result.ok ? result.stdout : result.stderr;
elements.output.textContent = `${output}\n耗时:${result.duration ?? "未知"} ms`;
成功时显示 stdout,失败时显示 stderr,两种情况都显示耗时。onStatus 则在结果到达前更新“加载 Python”和“执行中”,让用户看到运行仍在进行。
输出面板对应的是一组状态转换,而不是只在完成时填入文本:
查看 Mermaid 源码
stateDiagram-v2
    [*] --> 未运行
    未运行 --> 加载中: 点击运行
    加载中 --> 执行中: runtime ready
    加载中 --> 运行失败: Worker / 运行时加载错误
    执行中 --> 已完成: ok=true
    执行中 --> 运行失败: ok=false
    执行中 --> 已超时: 超过时间限制
    已完成 --> 未运行: 重置
    运行失败 --> 未运行: 重置
已超时 --> 未运行: 重置四类结束结果都沿同一协议返回:正常完成保留 stdout,语言异常保留 stderr,加载失败返回环境错误,超时由 Runner 生成时间限制结果并终止 Worker。重置时清空文本并调用 dispose,让 UI 状态和真实计算状态一起回到“未运行”。
因此 Python 的 IndexError、SQL 的语法错误和 JavaScript 的运行时异常都可以沿同一条 UI 路径显示;差异只保留在 stderr 的错误文本中。
四个阶段现在沿着同一份 input 闭合:代码块提供输入,createRunner 选择语言运行器,Worker 承载执行,输出面板消费 RunResult。下面把这条通用链路落到 Pyodide,完整跑一遍 print("Hello, World")。
把第三点的四个阶段合起来,一次运行就是下面这条链路:
查看 Mermaid 源码
flowchart LR
    sourceCode["固定 code 字符串"]
    languageRunner["createRunner(language)"]
    workerIsolation["Worker 隔离执行"]
    languageRuntime["语言运行时"]
    runResult["RunResult"]
    outputPanel["状态 / 输出面板"]
sourceCode --> languageRunner --> workerIsolation --> languageRuntime --> runResult --> outputPanel闭环需要回答六个问题:输入从哪里来?语言由谁选择?运行时在哪里初始化?代码在哪个线程执行?异常和标准输出如何返回?超时后谁负责回收?第四点用 Python 把这六个问题完整走一遍。
完整回顾:用 Python 跑通一次执行
把语言运行器具体化为 Python:浏览器没有内置 Python 解释器,因此适配器选择 Pyodide。Pyodide 将 CPython 和部分 Python 生态编译为 WebAssembly,并提供 loadPyodide() 初始化运行时、runPythonAsync() 执行 Python 源代码。WebAssembly 让 Python 在浏览器的受控环境中运行,但 CPU、内存和页面权限仍属于当前浏览器标签页。
当前示例使用 Pyodide 0.29.0,只依赖标准库:
print("Hello, World")点击“运行”,在你的浏览器中执行这段固定示例。
预期输出是:
Hello, World第一次运行时,语言运行器需要从 CDN 加载 Pyodide;初始化完成后,才把 code 交给 runPythonAsync。标准输出通过 setStdout 收集,异常通过 catch 转换成 stderr,最后统一返回 RunResult。
查看 Mermaid 源码
sequenceDiagram
    participant UI as 页面主线程
    participant C as Worker 控制器
    participant W as Web Worker
    participant P as Pyodide
    UI->>C: run(code)
    C->>W: postMessage({type: "run", code})
    W->>P: loadPyodide()
    P-->>W: ready
    W->>P: runPythonAsync(code)
    P-->>W: stdout / exception
    W-->>C: result(ok, stdout, stderr, duration)
C-->>UI: 更新状态和输出面板这里的 Python 语言适配器只负责把 Pyodide 的 API 翻译成统一协议;app.js 中的控制器仍负责 Worker 的创建、消息和回收。若以后接入 JavaScript、SQL 或其它语言,可以复用控制器,只替换 Worker 内的语言适配器和运行时。
一次完整执行按时间顺序发生:页面从只读代码块得到 code;createRunner("python") 组装 Python Runner;Runner 创建 workers/python.worker.js 对应的 Worker;Worker 发送 loading 并通过 importScripts 加载 Pyodide;运行时准备好后发送 running;runPythonAsync(code) 产生 stdout 或异常;Worker 组装 RunResult;主线程根据 ok 显示输出或错误;超过 30 秒则由 Runner 终止 Worker。
仓库代码示例:把完整链路跑起来
为了便于解释和读者复现,这里准备了一个开源示例仓库:Chengyunlai/browser-code-runtime。仓库不依赖 React、Next.js 或构建工具,打开静态页面即可沿着 index.html、app.js 和 Worker 观察一次运行;README 说明仓库与博客的关系,docs/architecture.md 保存架构、时序和状态图。
git clone https://github.com/Chengyunlai/browser-code-runtime.git
cd browser-code-runtime
python3 -m http.server 4173
打开 http://localhost:4173,先点击“成功路径”,再点击“失败路径”。第一次运行会从 Pyodide CDN 下载 0.29.0;成功示例返回 Hello, World,失败示例返回 IndexError。
目录结构对应前面建立的执行链:
browser-code-runtime/
├── index.html
├── app.js
├── styles.css
├── workers/
│   └── python.worker.js
├── docs/
│   ├── architecture.md
│   ├── exercises.md
│   └── exercises-solutions.md
└── README.mdindex.html:固定代码和观察面板
页面不提供编辑器。data-language 标记运行语言,data-code 中的文本就是作者预置的输入,data-status 和 data-output 是观察运行过程的位置:
<section class="demo" data-example="success" data-language="python">
  <span data-status>未运行</span>
  <pre><code data-code>print("Hello, World")</code></pre>
  <button type="button" data-run>运行</button>
  <button type="button" data-reset>重置</button>
  <output data-output>点击“运行”查看输出。</output>
</section>
点击按钮时,页面只把 data-code 的字符串交给 Runner;styles.css 只负责外观,不参与执行链。
app.js:选择 Runner、通信和回收
app.js 把页面输入交给组装器,再通过统一的 CodeRunner 接口完成一次运行:点击时读取固定代码,createRunner 创建具体 Runner,状态消息更新徽标,最终结果写入输出面板。
在当前仓库中,语言选择和 Worker 文件的对应关系只有一条:
createRunner("python")
  → createWorkerRunner("./workers/python.worker.js")
  → new Worker("./workers/python.worker.js")
独立仓库为了能够直接用静态服务器启动,源文件保持原生 JavaScript;它实现的正是前面 TypeScript 示例中的组装器和 Worker 控制器。
const PYTHON_WORKER_URL = "./workers/python.worker.js";
const RUN_TIMEOUT_MS = 30_000;

function createRunner(language) {
  if (language === "python") return createWorkerRunner(PYTHON_WORKER_URL);
  throw new Error(`暂未注册 ${language} Runner`);
}

function createWorkerRunner(workerUrl) {
  let worker = null;
  let timeoutId = null;

  const dispose = () => {
    if (timeoutId) clearTimeout(timeoutId);
    timeoutId = null;
    worker?.terminate();
    worker = null;
  };

  const run = (code, onStatus) => new Promise((resolve) => {
    const startedAt = performance.now();
    dispose();
    worker = new Worker(workerUrl, { type: "classic" });
    worker.onmessage = ({ data }) => {
      if (data.type === "status") {
        onStatus(data.status);
        return;
      }
      resolve(data);
      dispose();
    };
    worker.onerror = (event) => {
      resolve({
        ok: false,
        stdout: "",
        stderr: event.message || "Worker 加载失败",
        duration: Math.round(performance.now() - startedAt),
      });
      dispose();
    };
    worker.postMessage({ type: "run", code });
    timeoutId = setTimeout(() => {
      resolve({
        ok: false,
        stdout: "",
        stderr: "执行超过 30 秒,已停止本次运行。",
        duration: RUN_TIMEOUT_MS,
      });
      dispose();
    }, RUN_TIMEOUT_MS);
  });

  return { run, dispose };
}
页面先用 getElements 读取 data-language 和 data-code,形成与前文相同的输入对象:
function getElements(card) {
  return {
    language: card.dataset.language || "python",
    code: card.querySelector("[data-code]").textContent,
  };
}
点击事件把这份输入交给 createRunner 返回的具体 Runner:
elements.runButton.addEventListener("click", async () => {
  elements.runButton.disabled = true;
  elements.status.textContent = "加载 Python";
  const runner = createRunner(elements.language);

  const input = {
    language: elements.language,
    code: elements.code,
  };

  const result = await runner.run(input.code, (status) => {
    elements.status.textContent =
      status === "running" ? "执行中" : `加载 ${input.language}`;
  });

  elements.status.textContent = result.ok ? "已完成" : "运行失败";
  const output = result.ok ? result.stdout : result.stderr;
  elements.output.textContent = `${output}\n耗时:${result.duration ?? "未知"} ms`;
  elements.runButton.disabled = false;
});从这里可以逐项对应四个阶段:input 来自代码块,createRunner(input.language) 组装 Runner,Runner 内部创建 Worker,elements.status 和 elements.output 展示状态与结果。
workers/python.worker.js:加载、执行和返回结果
workerUrl 指向的正是这个文件。3.3 中主线程执行 worker.postMessage({ type: "run", code }),这里由 self.onmessage 接收;3.3 中主线程监听 worker.onmessage,这里由 self.postMessage 发回 status 和 result。因此,5.3 不是另一条实现,而是 3.3 消息协议在 Worker 文件中的另一端:
| 3.3 的主线程代码 | python.worker.js 中的对应代码 |
|---|---|
new Worker(workerUrl) | 浏览器加载这个项目文件 |
worker.postMessage({ type: "run", code }) | self.onmessage 接收 run 消息 |
worker.onmessage | self.postMessage 发回 status / result |
worker.terminate() | 当前运行结束或超时时回收 Worker |
CodeRunner 的 RunResult | Worker 组装 ok、stdout、stderr、duration |
这个文件是项目自己编写的 Python 适配器。它接收主线程的 run 消息,加载所依赖的 Pyodide,执行代码,再把状态和结果发回主线程;仓库已经提供完整实现。
Worker 首次收到 run 消息时,通过 importScripts 从 jsDelivr CDN 下载 Pyodide 的加载脚本;loadPyodide 随后初始化 CPython WebAssembly 和运行时资源。pyodidePromise 避免当前 Worker 内发生重复初始化。这个最小仓库在一次运行结束后会终止 Worker,因此下一次点击会创建新实例;浏览器缓存仍可避免重复下载相同静态资源。如果要长期复用已初始化解释器,可以保留 Worker,但需要额外处理并发请求、状态污染和空闲回收。
let pyodidePromise;

async function getPyodide() {
  if (!pyodidePromise) {
    importScripts("https://cdn.jsdelivr.net/pyodide/v0.29.0/full/pyodide.js");
    pyodidePromise = loadPyodide({
      indexURL: "https://cdn.jsdelivr.net/pyodide/v0.29.0/full/",
    });
  }
  return pyodidePromise;
}
下面的执行入口就是前面协议中 self.onmessage 的具体实现:它把 Pyodide 的输出和异常转换为统一消息:
self.onmessage = async ({ data }) => {
  if (data?.type !== "run") return;
  const startedAt = performance.now();

  try {
    self.postMessage({ type: "status", status: "loading" });
    const pyodide = await getPyodide();
    self.postMessage({ type: "status", status: "running" });

    let stdout = "";
    let stderr = "";
    pyodide.setStdout({ batched: (text) => { stdout += text; } });
    pyodide.setStderr({ batched: (text) => { stderr += text; } });
    await pyodide.runPythonAsync(data.code);

    self.postMessage({
      type: "result", ok: true, stdout, stderr,
      duration: Math.round(performance.now() - startedAt),
    });
  } catch (error) {
    self.postMessage({
      type: "result", ok: false, stdout: "",
      stderr: error instanceof Error ? `${error.name}: ${error.message}` : String(error),
      duration: Math.round(performance.now() - startedAt),
    });
  }
};
用三条路径验证实现
成功路径返回 Hello, World,验证源代码 → Pyodide → stdout 的完整链路。异常路径使用确定会越界的代码:
values = [3, 1, 4]
print(values[3])点击“运行”,在你的浏览器中执行这段固定示例。
输出面板应显示 IndexError: list index out of range,而不是空白。若 CDN 初始化失败,状态会进入“运行失败”;若代码超过 30 秒没有结果,Runner 会终止 Worker,下一次点击重新创建实例。
仓库验证完后,可以抽出五个跨语言复用的边界:输入契约、run / dispose 生命周期、status / result 消息、RunResult 结果协议,以及只消费结果的输出面板。Pyodide 只是第二阶段的一个具体实现。
把同一个 Runner 接入 Blog
独立仓库验证的是 Runner 的最小链路,Blog 只需把 Markdown 围栏转换成同样的 code 输入,再接到页面组件。PythonDemo 负责按钮、状态、输出和重置;组件内部复用 Worker 与 Pyodide 的执行模型,不把 Pyodide 对象暴露给 MDX。
if (language === "python" || language === "py") {
  return <PythonDemo code={source} />;
}
完整、确定性、能在当前 Pyodide 运行时获得依赖的示例使用 python 围栏;依赖数据库、网络、密钥、本地文件或尚未接通运行器的语言使用 python-static 等静态围栏,只提供高亮和复制。这样 Blog 的内容层只声明语言和源代码,运行时细节留在组件与 Worker 中。
博客和独立仓库共享同一条数据流,但职责不同:仓库展示可独立启动的最小实现,Blog 负责 MDX 渲染、代码高亮、复制按钮、布局和文章中的交互。以后增加 JavaScript 或 SQL 时,内容层仍只声明语言和源代码,组件层按语言选择 Runner,页面继续消费 RunResult。
这个技术可以做什么
前面的实现把一段固定源代码转换成 RunResult。只要输入和输出仍然适合在浏览器中传递,这条链路就可以承载更多短时、可观察的代码实验:
查看 Mermaid 源码
flowchart TB
    runtime[浏览器代码运行器] --> tutorial[教程中的可运行示例]
    runtime --> lab[交互式算法实验]
    runtime --> data[SQL / 数据处理练习]
    runtime --> compiler[编译器与 WebAssembly 演示]
runtime --> validation[文章内的确定性验证]| 场景 | 代码运行器提供的能力 | 例子 |
|---|---|---|
| 教程和文档 | 固定代码、即时输出、错误回传 | Python 标准库、JavaScript 语法 |
| 算法实验 | 短时计算、耗时展示、重置后重新运行 | 排序、计数、图算法 |
| SQL 练习 | 在浏览器内准备内存数据库并返回表格结果 | SQLite-Wasm、DuckDB-Wasm |
| 编译目标演示 | 加载预编译模块并传入参数 | Rust / C / Go 编译为 WebAssembly |
| 文章验证 | 让输入、状态和输出沿同一条链路可观察 | 成功、异常、超时路径 |
这些场景仍遵循四阶段模型:代码块保存源代码,语言运行器准备解释器或编译产物,Worker 或其它隔离机制承载计算,输出面板消费统一结果。Python 使用 Pyodide;JavaScript 可以使用原生 Worker;SQL 可以使用 SQLite-Wasm 或 DuckDB-Wasm;Rust、C、C++、Go 可以使用预编译 WebAssembly 模块。
这类运行器适合确定性、短时、无需服务器权限的实验。需要 API key、内部数据库、文件写入、发布或支付等副作用时,执行边界应移到服务器端队列或专用沙箱;浏览器 Worker 只负责承载当前页面内的计算。
回到开篇的“运行按钮”:按钮读取固定源代码,createRunner 组装 Python Runner,Runner 在 Worker 中准备 Pyodide,执行后把 stdout、stderr、耗时和状态送回输出面板。浏览器运行的不是按钮本身,而是这条由组装器、适配器和运行时共同完成的执行链。
课后练习:如果换成 JavaScript 或 SQL 呢
读完 Python 版本后,可以尝试在同一个仓库中增加第二个语言运行器。练习可以新增示例卡片,但不需要改变 index.html 的输入结构和输出面板;只替换第二阶段的语言运行器,并保持同一组 status、result 和 RunResult 字段。
仓库的 docs/exercises.md 已经准备了两道练习,完成后可以对照 docs/exercises-solutions.md 中的参考答案:
- JavaScript Runner:新增
workers/javascript.worker.js,在 Worker 中执行确定性的 JavaScript 计算,捕获返回值或异常,并在createRunner("javascript")注册它。 - SQL Runner:选择 SQLite-Wasm 或 DuckDB-Wasm,新增 SQL Worker,初始化内存数据库,把查询结果序列化为
stdout或结构化输出,并处理语法错误。
每道练习都给出目录位置、消息协议、成功与失败路径、完成标准和安全边界。完成后可以把同一个按钮分别接到 Python、JavaScript 和 SQL,观察第一、三、四阶段保持不变,只有第二阶段的语言运行器发生替换。
参考资料
- Pyodide Usage(官方文档,访问日期:2026-08-25)
- MDN: Web Workers API(规范文档,访问日期:2026-08-25)
- PyScript Documentation(官方文档,访问日期:2026-08-25)
Footnotes
-
Pyodide 官方文档:将 CPython 和 Python 科学计算生态编译为 WebAssembly,供浏览器和 Node.js 使用。 ↩
-
SQLite Wasm 官方文档:SQLite 面向 WebAssembly 的构建与浏览器使用说明。 ↩
-
DuckDB-Wasm 官方文档:DuckDB 在浏览器中的 WebAssembly 客户端说明。 ↩